Un artículo publicado hace tres minutos que no aparece en Google News hasta el día siguiente es un artículo muerto. En un sitio de noticias, la velocidad de indexación condiciona la visibilidad. El sitemap dedicado a las noticias es el recurso técnico que acelera esta consideración por parte de los robots.
No estamos hablando aquí del mapa del sitio clásico mostrado a los visitantes. El sitemap XML para noticias es un archivo estructurado, leído por los motores de búsqueda, que señala en tiempo real los contenidos recién publicados. Su configuración difiere radicalmente de un sitemap estándar, y es precisamente esta diferencia la que plantea problemas a la mayoría de las redacciones en línea.
Ventana de 48 horas y límite de 1,000 artículos: las restricciones específicas del sitemap de noticias
Cuando se gestiona un sitio de información, se descubre rápidamente que Google aplica reglas estrictas al sitemap de noticias. El archivo solo debe contener artículos publicados en los últimos dos días. Más allá de eso, las URL ya no tienen cabida en este archivo (permanecen en el sitemap general del sitio).
La segunda restricción se refiere al volumen: cada archivo está limitado a 1,000 etiquetas news:news. Para una redacción que publica masivamente, es necesario dividir el sitemap en varios archivos y agruparlos a través de un índice. Ignorar este límite equivale a arriesgarse a que Google solo lea una parte del archivo, dejando artículos recientes fuera de su radar.
Para cada URL, deben figurar campos obligatorios en el XML: el nombre exacto de la publicación, el idioma, la fecha de primera publicación en formato W3C y el título del artículo. El título no debe contener ni el nombre del medio ni el del autor. Este último punto suele estar mal configurado, lo que provoca rechazos silenciosos en la Search Console.
Para observar cómo un sitio de información estructura concretamente esta jerarquía, se puede consultar el sitemap de La Gazette de Constantine y verificar la forma en que las URL están organizadas por categoría y por fecha.
Sitemap de noticias como flujo en tiempo real: por qué la actualización automática lo cambia todo
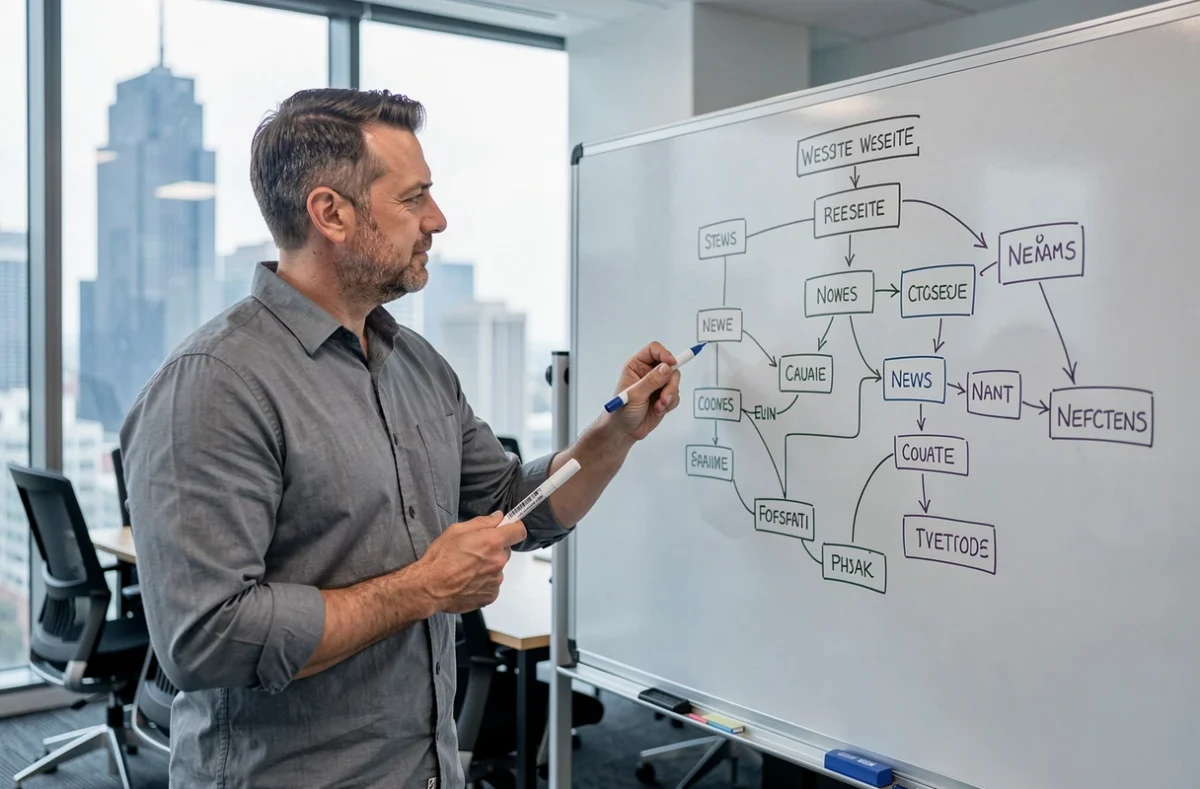
Un sitemap estático, regenerado una vez al día, ya no es suficiente para un sitio de noticias. La tendencia observada entre los editores en los últimos años consiste en tratar el sitemap de noticias como un flujo dinámico, actualizado en los minutos que siguen a cada publicación.
Concretamente, esto significa que el CMS (WordPress, Drupal o sistema propio) debe activar la regeneración del archivo XML tan pronto como un artículo pasa a estado “publicado”. En WordPress, extensiones como SEO Press o Yoast gestionan esta automatización. En un CMS propietario, es el desarrollador quien debe codificar este disparador.
Un sitemap actualizado al minuto reduce el tiempo de indexación de manera significativa en comparación con una regeneración diaria. Los resultados varían en este punto según la frecuencia de rastreo que Google otorga al dominio, pero el principio sigue siendo el mismo: cuanto más fresco es el archivo, más rápido pasa el robot.
Los peligros de la actualización automática
Automatizar no significa olvidar. Tres errores se repiten regularmente en las redacciones:
- Dejar artículos en borrador o en “prepublicación” aparecer en el sitemap, lo que envía a Google URL que devuelven un error 404 o una página protegida.
- No retirar los artículos de más de 48 horas del sitemap de noticias, lo que viola la restricción de frescura y puede provocar una advertencia en la Search Console.
- Modificar el título de un artículo después de la publicación sin que la etiqueta
news:newsse actualice en el XML, creando una incoherencia entre el archivo y la página real.
Etiquetas XML obligatorias para un sitemap de Google Noticias
El sitemap de noticias utiliza un espacio de nombres XML específico que se añade al protocolo de sitemap estándar. Sin este espacio de nombres, Google ignora pura y simplemente la información de noticias y trata el archivo como un sitemap ordinario.
A continuación, se presentan las etiquetas que deben integrarse para cada artículo:
news:publicationcontiene dos subetiquetas:news:name(el nombre exacto del medio tal como está registrado en Google News) ynews:language(código de idioma ISO, por ejemplo “es”).news:publication_dateindica la fecha y hora de primera publicación, en formato W3C completo (año-mes-díaThora:minuto:segundozona).news:titleretoma el título del artículo, sin mención del medio ni del autor. Un título mal formateado provoca un rechazo silencioso en el índice de noticias.
El nombre de publicación en la etiqueta news:name debe coincidir exactamente con el declarado en el Centro para editores de Google. Una mayúscula de más, un acento faltante, y el vínculo entre el sitemap y la cuenta de editor se rompe.
Verificación en la Search Console
Después de enviar el sitemap en Google Search Console (sección Sitemaps, URL directa del archivo), se supervisan dos indicadores: el número de URL detectadas y el número de URL indexadas. Una diferencia importante entre ambos señala un problema de formato o de contenido. La consola también muestra los errores específicos de las etiquetas de noticias, lo que permite corregir rápidamente una configuración defectuosa.
Sitemap HTML y sitemap XML: dos usos distintos para un sitio de noticias
Se confunden a menudo el sitemap XML (destinado a los robots) y el sitemap HTML (destinado a los lectores). En un sitio de noticias, ambos tienen su utilidad, pero no cumplen la misma función.
El sitemap HTML es una página de navegación accesible a los visitantes, que lista las secciones, las categorías y a veces los artículos recientes. Ayuda a un lector perdido a encontrar una sección del sitio. Para el SEO, distribuye enlaces internos hacia páginas profundas que la navegación principal no destaca.
El sitemap XML, por su parte, nunca es visto por los lectores. Habla exclusivamente a los motores de búsqueda. Para un sitio de noticias, en realidad se mantienen varios archivos XML: un sitemap general (todas las páginas permanentes), un sitemap de noticias (artículos de las últimas 48 horas) y, eventualmente, un sitemap de imágenes o videos si el sitio publica regularmente.
Separar estos archivos evita ahogar los artículos frescos en una masa de URL antiguas. Google otorga una prioridad de rastreo diferente según el tipo de sitemap, y esta separación le facilita el trabajo.
El punto técnico que a menudo pasa desapercibido: un índice de sitemap (archivo que lista todos los subsitemaps) debe ser declarado en el archivo robots.txt en la raíz del sitio. Sin esta declaración, los robots no descubren automáticamente los archivos secundarios, incluso si están correctamente formateados.